GPT-6.2 如何分配任務,先算每份驗收成果的成本
Astra 與 Sol 的價差只是起點。重試、人工複核與交付期限,才決定哪條模型路線更划算。
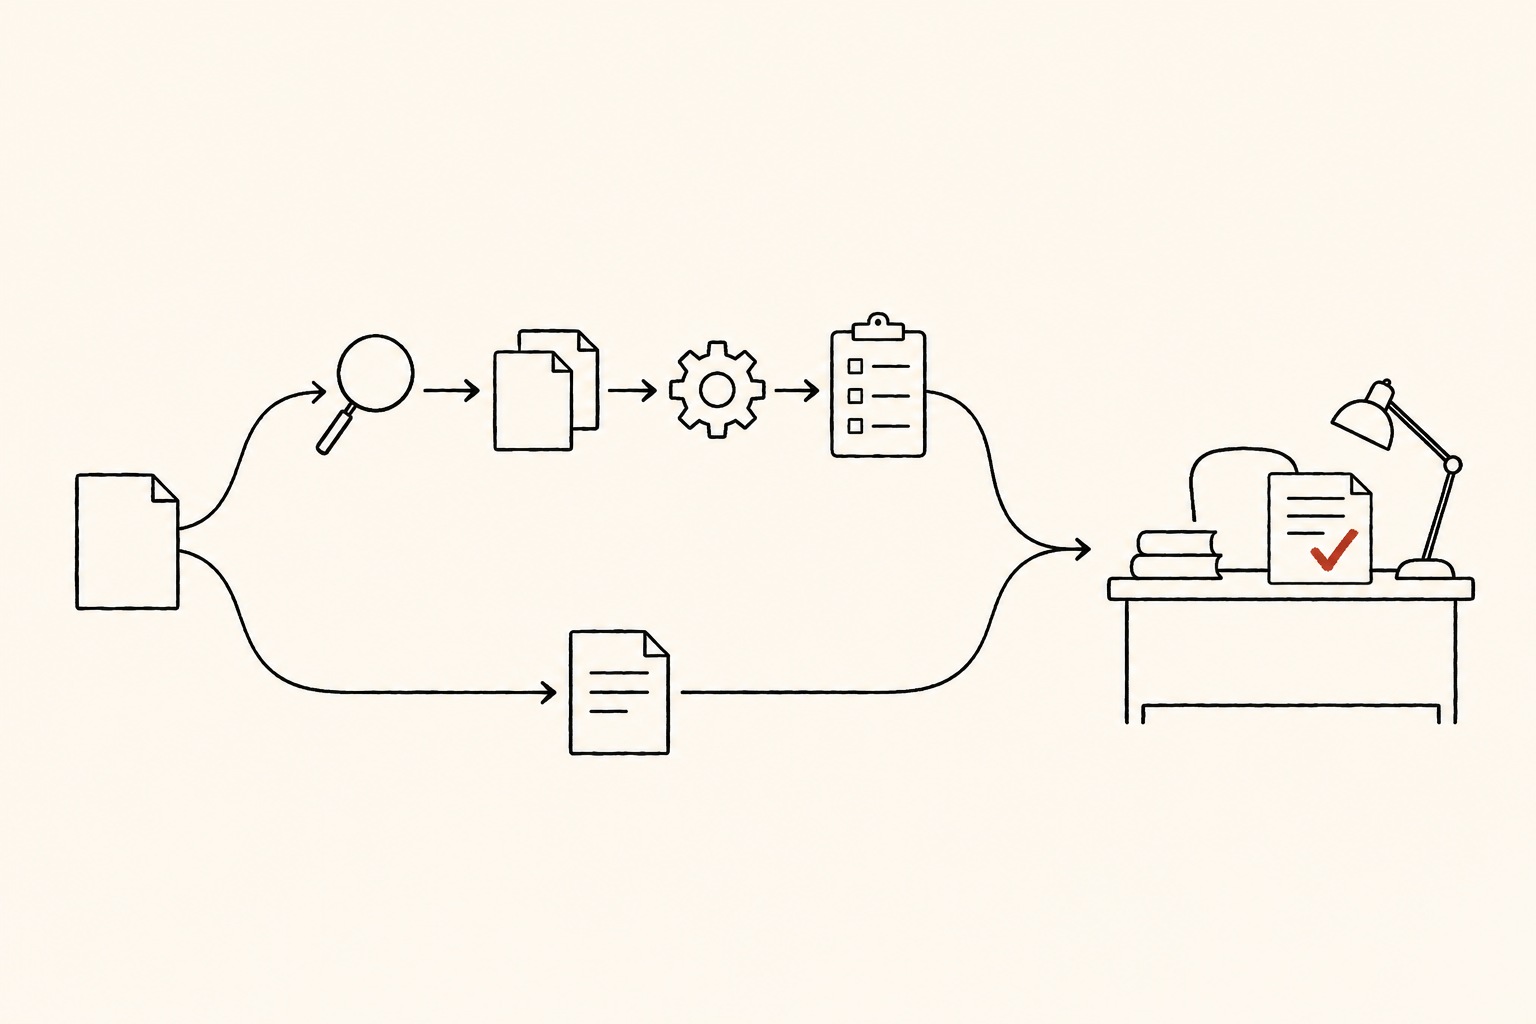
OpenAI 於11月17日發布 GPT-6.2 Astra 與 Sol,分別定位於高難度專案與日常工作。官方發布說明帶來一個實際問題:哪些任務應交給哪個模型?答案不應只來自每百萬 token 的報價,也不應把所有工作一律交給能力較強的型號。
真正值得比較的是,在相同品質要求與期限下,每份通過驗收的成果需要多少總成本。便宜的初稿若需要更多修改,可能只是把費用轉移給審核者;較貴的呼叫若沒有改善可用成果,也未必值得。
呼叫價格不等於交付價格
以短上下文 Standard 文字計費來看,Sol 模型頁列出每百萬輸入 token 2美元、輸出10美元;Astra 模型頁分別為8美元與40美元。這些是計費單位,不是固定任務價格。輸入、輸出長度與重試次數都會改變帳單。
評估時應固定計費條件,再記錄實際用量。API 價目表區分快取、處理層級與上下文條件。不要把某模型的優惠背景處理和另一模型的即時處理混在一起比較。以下只使用 Standard、未快取、短上下文文字價格,不推算訂閱方案額度。
內部指標可以是:同一批任務的模型及工具費用,加上人工複核與返工成本,再除以依約通過驗收的成果數。失敗、逾時、放棄及升級模型的支出都保留在分子。如果沒有成果通過,就應視為這條路線尚不可用,而不是製造漂亮的平均值。
一個明確是假設的算例
以下不是 Astra 或 Sol 的實測表現。假設同一批100項低風險工作採用相同驗收標準,每項須在30分鐘內完成;兩條路線都交付95份合格成果,並符合事先設定的相同錯誤容忍門檻。其餘5項失敗的費用仍計入。人工按每分鐘1美元估值,包括複核、修改及失敗處理。
為方便計算,假設每次呼叫使用1萬輸入 token、2000計費輸出 token,後者包含適用的推理 token,沒有快取或工具費用。因此 Sol 每次0.04美元,Astra每次0.16美元。真實重試可能帶有更長歷史,這裡刻意簡化。
- Sol路線:100次初始呼叫與20次重試,共4.80美元;人工共300分鐘,即300美元。合計304.80美元,除以95份成果,每份約3.21美元。
- Astra路線:100次初始呼叫與5次重試,共16.80美元;人工共190分鐘,即190美元。合計206.80美元,每份約2.18美元。
在這組假設下,Astra模型費用多12美元,但人工少110分鐘,總成本較低。這不是「Astra永遠比較省」的結論。若人工時間相同,Sol反而便宜;依本例的人工估值,Astra只要節省超過12分鐘即可抵銷額外模型費用。企業應以實際觀察替換假設,不能把算例當成採購證據。
人工估值也不是現金節省。審核時間減少,可能增加可處理的工作量,卻不一定降低薪資支出。財務報告應分開記錄釋出的產能與真正減少的付款。
基準能提出問題,不能代替驗收
Cognition的FrontierCode 2.0方法說明採用加權評分,未通過阻斷性標準的結果記零,成本是依API報價計算的每次執行平均支出。分數不能直接當作公式中的驗收率,執行費用也不是包含人工的交付成本。
官方排行榜著眼於程式碼是否達到維護者願意合併的標準。這是有用的角度,卻不能證明報表、業務郵件或企業特定程式庫也具有相同排名。本文不把廠商分差推論為企業報酬,也不據此假設兩個模型品質相同。
企業可建立按任務分類的小樣本:規範明確的格式整理、需要查證的資料整合、跨模組修改分開計算。讓審核者不知道模型名稱,固定驗收規則,記錄首次通過率、總重試數、人工修改時間與交付後缺陷。小樣本的偶然優勢,應透過重複批次確認。
路由規則要計入升級成本與停止條件
可測試的一種策略,是由Sol先處理範圍明確、可回復的工作,只有出現可檢查的失敗訊號才升級,例如測試失敗、必要來源缺漏或超過預設返工次數。交給Astra的應包含原任務、已驗證事實及失敗原因,而非沒有背景的未完成稿。
但「先便宜再升級」不必然省錢。首輪支出、整理交接材料的時間及再次讀取上下文的費用,都屬於同一任務。若某類工作經常升級,直接交給Astra可能更合理。路由器本身的分類費用與誤分配也應計入。
測試應比較三條完整路線:直接Sol、直接Astra,以及Sol按規則升級。給予相同期限、工具權限與品質門檻,觀察交付延遲分布,不只看平均回應時間。逾期的好答案不算準時交付;事後發現重大錯誤,應撤回原驗收並補記修復成本。
本文討論低風險、可審核的工作分配,不涵蓋醫療或法律判斷、資金交易、不可逆業務操作及安全測試。模型路由不能取代必要的人類核准。值得保留的規則,應能解釋哪些任務在什麼條件下更省、更可靠,並在模型、價格或工作組成變動後重新驗證。
內容僅供參考,不構成投資、法律、稅務或財務建議。