反蒸餾防禦,還需要一張客戶端成績單
安全措施是否有效,與正常客戶能否完成工作,需要分別驗收。
新聞與證據邊界
2026年10月12日,Anthropic 披露了更強的反蒸餾措施,稱其減少了未經授權的提取,同時努力保留正常使用體驗。這是公司評估,並非獨立重現結果。
2026年6月的一篇預印本以查詢預算、訓練資料預算和 API 介面界定評估條件。它沒有獨立驗證 Anthropic 10月的部署。Claude 官方評測文件則建議採用可衡量、貼近具體任務的標準,並與基準比較。
分析:需要兩張成績單
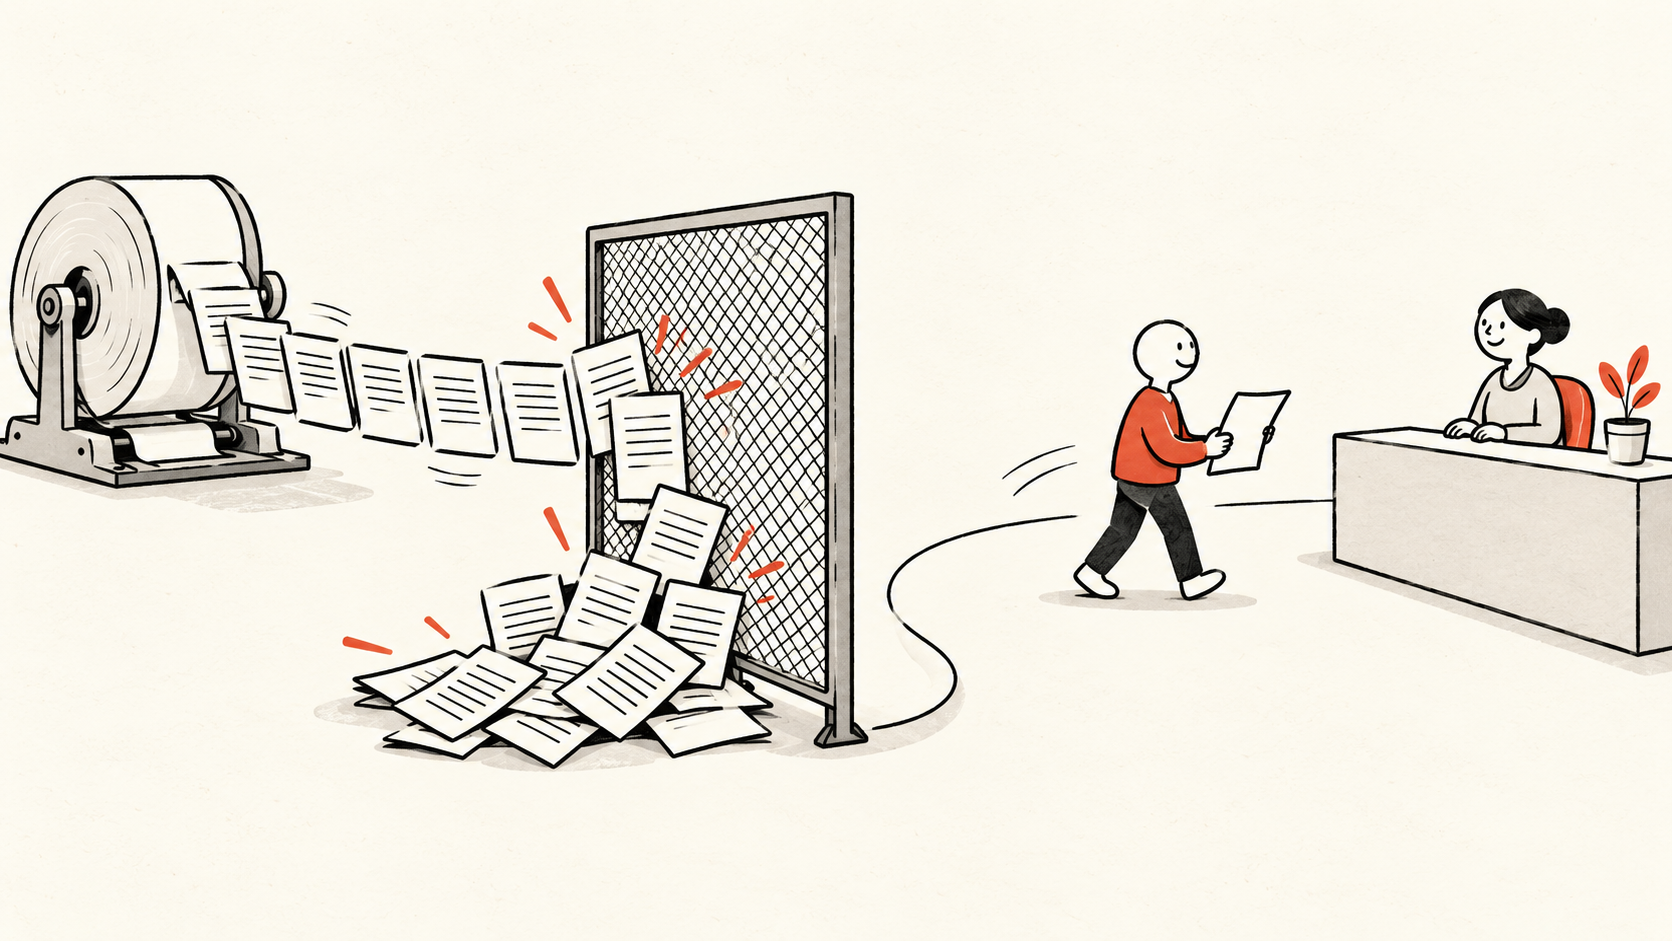
Open Market Notes 的判斷是,採購評估需要兩張成績單。一張回答:在明確條件下,防禦是否提高了複製有效能力的成本?另一張回答:獲得授權的客戶還能否完成自己的工作?前一個問題表現良好,邏輯上並不能證明後一個問題也已解決。
設想一個客服應用。它可能仍能流暢回答,卻不再穩定保留訂單編號,或者不能正確執行退款規則。寬泛的語言品質評分可能漏掉這種失敗。反過來,措辭發生輕微變化,也不必然意味著服務失去了有用能力。這些是假設示例,不是 Anthropic 已發生的事件;它們說明,購買方需要自己的驗收標準。
一種可審查的內部測試,是固定一組合法、非敏感的真實任務樣本,寫明預期業務結果,再比較服務變化前後的同一工作流程。記錄模型識別碼、日期、提示詞版本、工具、重試次數和人工修正。任務完成率應與拒答率分開:API 接受請求並回傳答案,不代表業務任務完成。
不只記錄錯誤,也記錄恢復
下面是說明性計算,不是廠商基準測試。假設1,000項正常任務的錯誤拒答率從1%升至2%,就會增加10項被阻斷的任務。如果每項需要六分鐘複核,額外負擔是一小時人工。這個數字不能說明攻擊防禦效果,只是讓一種可能的客戶端成本變得可見。
接下來的營運問題是:團隊能否識別、申訴並解決錯誤,而不是靠不斷重試把錯誤藏起來?沒有記錄的繞行,可能讓儀表板更好看,卻把成本轉移給員工。經過批准的備用流程應保留原始失敗記錄,並單獨衡量恢復後的結果。
還有什麼不能下結論
上述來源沒有提供我們獨立取得的、逐項應用層面的最新防禦效果。因此,不能據此推斷所有任務都出現品質下降,也不能承諾防護會長期有效。下一步有價值的證據,應同時包含邊界清楚的安全評測、可重現的客戶任務結果,以及明確的糾錯路徑。對購買方而言,真正有意義的單位是可靠完成的一項授權工作流程,而不只是一次成功回傳。
內容僅供參考,不構成投資、法律、稅務或財務建議。