蒸留対策には顧客側の評価表も必要だ
防御の効果と正当な業務の完了は、別々の基準で検証する必要がある。
ニュースと証拠の範囲
2026年10月12日、Anthropicは蒸留対策の強化を報告した。不正な抽出を減らしつつ、正当な利用を維持する取り組みという。企業自身の評価であり、独立した追試ではない。
2026年6月のプレプリントは、問い合わせ予算、学習データ予算、APIのインターフェースで評価条件を整理している。Anthropicの10月の導入を独立検証した研究ではない。Claudeの評価文書も、測定可能で業務に即した基準と、ベースラインとの比較を勧めている。
分析:二つの評価表が必要になる
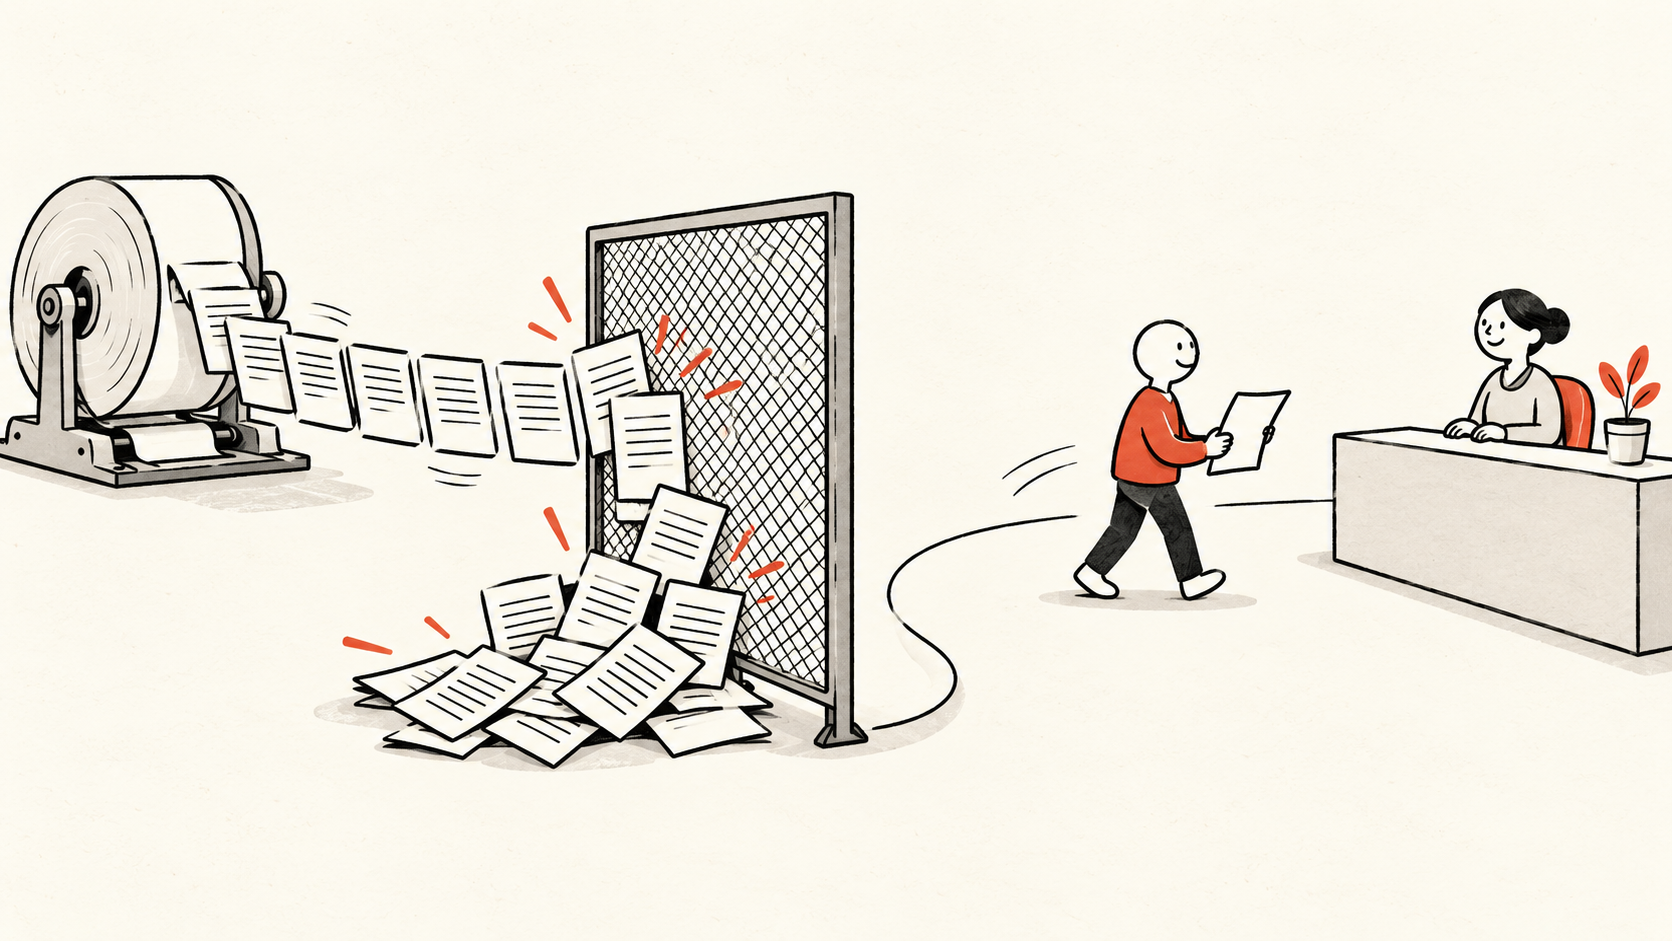
Open Market Notesの見方では、調達判断には二つの評価表が必要だ。一つは、条件を明示したうえで、有用な能力を複製するコストが対策によって上がるかを問う。もう一つは、利用を許可された顧客が自分の業務を完了できるかを問う。片方の好結果から、もう片方の好結果を論理的に導くことはできない。
仮にカスタマーサポートのアプリを考えてみよう。回答は流暢でも、注文番号を正確に保持できなくなったり、返金ルールの適用を誤ったりする可能性がある。一般的な言語品質の点数では、その失敗を見落とすかもしれない。逆に、表現が少し変わっただけで有用な能力が失われたとは限らない。これはAnthropicで観測した事例ではなく、購入側に独自の受け入れ基準が必要な理由を示す仮定だ。
検証可能な社内テストでは、適法で機微情報を含まない実務サンプルを固定し、期待する業務結果を定め、サービス変更の前後で同じワークフローを比較する。モデル識別子、日付、プロンプトの版、ツール、再試行、人による修正を記録する。タスク完了率と拒否率は別に扱う。APIが正常に応答しても、業務が完了したとは限らない。
エラーと復旧を分けて測る
次は説明用の計算であり、ベンダーの実測値ではない。正当な1,000件のタスクで誤拒否率が1%から2%に上がれば、停止するタスクが10件増える。各件の確認に6分かかるなら、追加負担は1人時だ。この数字は攻撃防止の効果を示さない。顧客側に生じ得るコストの一つを可視化するだけだ。
運用上の論点は、エラーを特定し、異議を申し立て、解決できるかである。繰り返し再試行して問題を隠すこととは違う。記録のない迂回策は、ダッシュボードを良く見せながら従業員に負担を移すことがある。承認された代替手順では、元の失敗記録を保持し、復旧後の結果を別に測る必要がある。
まだ判断できないこと
今回の資料からは、最新対策についてアプリごとの独立した測定結果は得られない。したがって、一律の品質低下も、持続的な防御の保証も導けない。次に有用なのは、範囲を明確にしたセキュリティ評価、再現可能な顧客タスクの結果、文書化された訂正経路を組み合わせた証拠だ。購入側にとって意味のある単位は、成功応答の件数だけではなく、許可された業務を確実に完了した件数である。
情報提供を目的とした内容です。投資・法律・税務・財務上の助言には該当しません。